跳到主要内容

微信所谓自动登录还要你手动点按钮?写个程序帮你点!

· 阅读需 3 分钟
兔兔
兔兔

你有没有遇到过这种情况:电脑一开机,微信设了开机启动,自己蹦出来了,结果还卡在登录页等你点那个绿色的大按钮。但凡忘记了,他就一直在后台待着

微信老早就支持所谓“自动登录”,结果这么多年过去了,还是不能电脑打开了,微信自己登录上,只好写个工具自己动手了

我的需求其实很简单:

  1. 微信开了,检测到登录页,自动登录
  2. 不要抢鼠标,尽可能安静的解决。不然可能造成意外的问题

第二点是我特意做的设计,很多"自动点击"类的软件,原理基本都是模拟鼠标移动去点。但凡你在用电脑,点击就丢了,要么就点歪。所以这次我换了个思路:直接给微信窗口发一条"点击"消息,就好比程序转发了一次鼠标事件。微信确实登录成功了,然后鼠标完全不受干扰,你鼠标怎么晃都没影响,被别的窗口挡住了,在后台它也能点到(消息是点对点发给窗口的嘛)。

然后程序会检测微信状态,检测到成功就会自动退出后台。

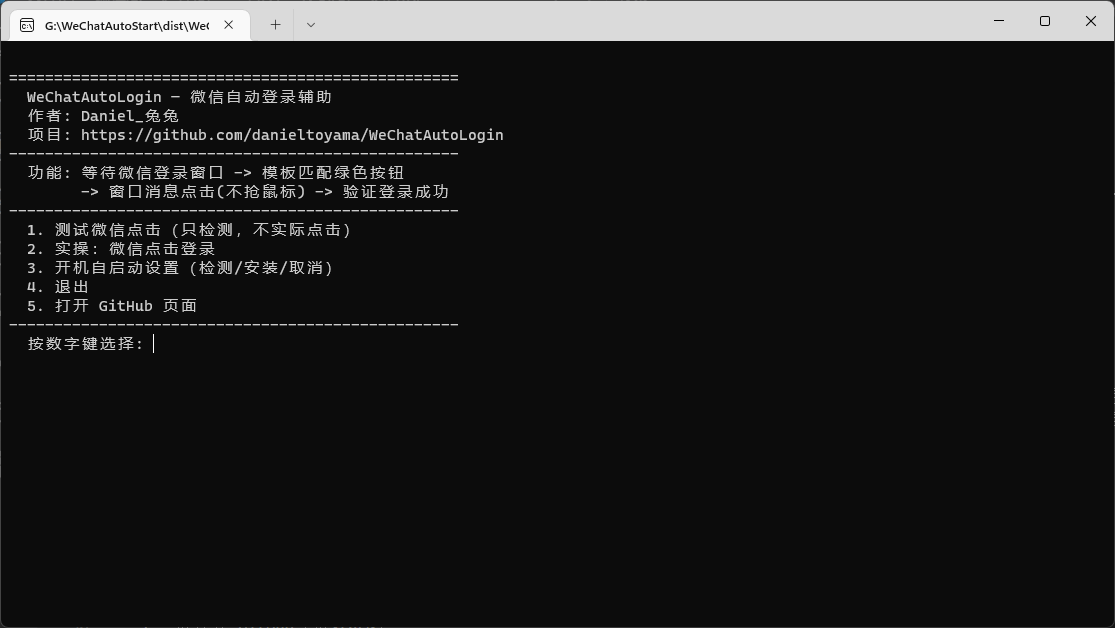
功能上现在是这样:双击 exe 会弹出菜单,按数字键运行:

  • 1 测试 (用于识别目前的微信窗口状态,是否能读取到登录键)
  • 2 实操 (直接试试能不能点击微信按钮)
  • 3 开机自启设置(检测自启功能启动状态,安装/取消都自动弹 UAC)
  • 5 一键打开 GitHub(求star~)

github开源链接

蓝奏云下载 密码:h84x

可以选择从构建运行,或者直接使用蓝奏云的exe。就是体积有点大,python嘛,没办法

可以的话记得点个star支持一下我喔

给Onebot11项目快速对接官方机器人!

· 阅读需 11 分钟
兔兔
兔兔

写这篇文章的起因,是我运营的Sparkbridge-群服mc机器人互通项目,作为一个onebot11的传统项目——需要小号挂机、容易掉线、动不动被风控,越来越多群友抱怨说bot登录不上,疯狂掉线,所以这俩天我都在想对策。

刚好看见有群友提到,现在其实 QQ 官方机器人(开放平台注册的那种)现在的能力还过得去,基本的信息获取都没问题,我就花了这几天时间,整理一下手头能想得到的方案,看中了之前经常使用的项目,Gensokyo,一个把"QQ 官方机器人 API"转换成"OneBot v11 协议"的转换器。

这个 Gensokyo 是什么,为什么现在要下载 fork 魔改的版本

Gensokyo官方版本 上游本来就是把官方机器人 API 转成 OneBot 协议的转换器,但原版更新较慢,已经落后QQ官方的api更新大半年,缺少群服互通这类场景需要的能力,连获取全量信息都不支持。我也是根据我们bot互通需要的能力,基于上游重新 fork 魔改,得到了目前的产物:Gensokyo-ForSpark主要增加了:

  • 群全量消息接收GROUP_MESSAGE_CREATE,不要求 @ 机器人)
  • 主动消息发送(无被动窗口也能直接发)
  • 官方昵称回填sender.nickname/card 不再是空的)
  • 群聊管理全套:官方 2026-08 新增的群管理接口/事件(群成员加/退、入群申请与审批、禁言、机器人状态、入群自动审批策略等)
  • OneBot 兼容性修复:未支持的 action 也回合法 JSON(不再让对端等超时崩溃)、get_stranger_info 实现、入群审批兼容只传 flag 的插件、@ 的出入站转换等(做这个是发现有些api,请求的时候不支持就直接丢一个undefined回来,直接把bot崩溃了,就写了个保底)

其实关于这个get_stranger_info,他基本上没有什么实质功能,只是做了个虚拟保底。因为我发现有些新人识别插件会检测性别QQ等级啥的,所以就直接传个9999回来,这样也就避免无效值拉不了人。

需要说明:这个版本主要针对我们的SparkBridge 群服互通环境制作,不保证其他 OneBot v11 客户端能完美工作;但实现上遵循 OneBot v11 标准,理论上支持大多数 OB11 API

方案优点

  • 官方机器人接入:无需普通 QQ 小号挂机,不需要手机/电脑保持在线、不会被挤下线
  • 不掉线:官方 WebSocket 网关 + 自动重连,无登录态过期、无第三方协议风控,长期稳定
  • 全局信息:消息走官方云端 API,与客户端/设备解耦,重启即恢复
  • 不易封号:官方通道合法合规,不存在封杀第三方协议的风险

方案边界

  • QQ号,群号全虚拟:官方里面所有的个人信息都是openid格式,gsk用md5算法转换为数字。无法获得真实QQ号群号。不过作为用户标记也勉强够用
  • 无真 @:官方不渲染 @ 标签,at 段会自动转成 @昵称 文本
  • 主动消息频控:Bot 维度 60 QPM(未认证 30 QPM),单关系 20 QPM,不适合高频刷屏
  • 官方接口能力有限:踢人、bot主动退群、改群名、拉取成员列表等官方 API 没有
  • 群管理操作,主动信息能力需群主亲自许可:入群审批、群禁言等需要机器人是群管理员,主动信息获取需要群主在手机 QQ 客户端给机器人配置权限
  • 部分资料不可得:QQ 等级、性别、年龄官方不提供
  • 链接域名校验:消息里的链接需过 QQ 校验,gsk 提供自动二维码/短链两种规避方式

第一步:申请一个 QQ 官方机器人

配置注册bot流程也可以参考我之前配置 SparkbridgeBot 的视频:

BILIBILI[Sparkbridge3]对接官方!不掉线的基岩服务器Bot!

在开始配置前,你得先有一个官方机器人。流程很简单,几分钟搞定:

  1. 打开 QQ 开放平台,用 QQ 扫码登录
  2. 进入「应用管理」→ 创建应用,类型选机器人
  3. 填写应用信息(名称、简介、头像等),提交后不需要审核,秒过
  4. 注册完毕后,在「开发设置」里拿到三个关键凭据,保存好
    • AppID(应用ID)
    • AppSecret(客户端密钥)(找不到就右上角切旧版平台 → 开发设置)
    • Token(应用令牌)
  5. 机器人创建后会自动出现在你的好友列表,把它拉进群:群主在qq群添加界面搜索机器人添加进群。没错,所以你最好是群主,这样流程最简单。
  6. 群主在手机 QQ 客户端给机器人配置权限
    • 许可机器人获取信息范围为「所有消息」
    • 允许机器人在群内主动发言
    • (看不到选项就更新一下 QQ,9.2.90才有这个东西)
    • 需要入群审批、禁言等群管理功能的话,把机器人设为群管理员

权限不给齐,后面会各种"没反应"

收不到消息、主动消息报"无权限"、审批点不了。先配权限再往下走。

快速配置(不用手写 yaml)

嫌弃自带的config太多乱七八糟的,看的头疼,搞了个可视化配置生成器,浏览器直接打开:

打开 Gensokyo 配置生成器

生成的配置不带官方注释

要自己改配置的话,建议先用官方配置生成一份对照着看,再手动加注释。

只需填:

必填说明
应用ID / 应用令牌 / 客户端密钥QQ 开放平台 → 开发设置
机器人QQ号点机器人资料卡查看
监听端口默认 15630
正向WS令牌你的 OneBot 客户端连接时用的密码

事件订阅全部勾选即可,然后下载生成的 config.yml 覆盖到 Gensokyo 目录,重启。

如果你不放心我的生成器,担心透露你的隐私——它是个纯前端静态页面,不发任何网络请求,可以 F12 自行审阅代码。

运行环境:需要下载编译好的 Gensokyo 可执行文件(GitHub 仓库),以及一个按上面流程申请的 QQ 官方机器人。

你的 OneBot 客户端怎么连

你的客户端(AnyOneBot 框架/插件)用正向 WebSocket 连接 Gensokyo:

  • 地址:ws://Gensokyo所在机器IP:端口
  • 令牌:配置生成器里填的那个正向WS令牌

连上之后,框架收到的就是标准 OneBot v11 事件,原有的事件处理和 API 调用照常。

一个更重要的建议

如果你的 OneBot 生态(NoneBot、Koishi 等)本身就有开箱即用的官方机器人适配器——比如 Koishi 的 qq-official、NoneBot 的 QQ 官方适配——优先用它们。官方适配器是社区为对应框架深度打磨的,类型定义、事件模型、文档都更完善。

这个魔改 Gensokyo 的价值,在于给"必须走 OneBot v11 协议"的项目(比如 SparkBridge 这类直接按 OneBot 协议对接的)一条接入官方机器人的路,省去小号挂机的烦恼。

常见问题

Q: 连接不上,日志显示鉴权失败

检查两边的令牌是否一致:Gensokyo 配置里的 ws_server_token 和你 OneBot 客户端连接时填的令牌必须完全相同。

Q: 日志报"主动消息失败, 无权限"

官方机器人没有开通主动消息权限。让群主在手机 QQ 客户端给机器人开启"允许主动发言"。

Q: 群里收不到消息

① Gensokyo 事件订阅里勾选群全量消息GroupMessageEventHandler);② 群主在手机 QQ 客户端许可机器人获取信息范围为「所有消息」。

Q: @ 显示不出来,只看到 @昵称 文字

官方 API 不支持真 @ 标签,这是官方限制不是 bug,方案边界里也写了。

Q: 发出去的链接显示原文或被拦

QQ 对消息里的链接有域名校验。在配置生成器⑤里选二维码模式(推荐)或短链模式(这个要自己配置白名单过审域名302跳转的)即可规避。


有问题欢迎留言交流。

关于js中如何避免回调地狱的问题

· 阅读需 7 分钟
兔兔
兔兔

很多js新人———嗯,也包括我,在js里第一次写东西的时候,接触到了axios,和很多萌新一样,我最早学会的js请求就只会最基本的回调函数:

axios.get('/api/data')
.then(response => {
// 处理数据
const data = response.data;
return anotherRequest(data.id); //调用数据
})
.then(secondResponse => {
// 嵌套层级增加......
})
.catch(error => {
// 错误处理
});

这样搞多了,复杂点的逻辑就会变成灾难性的回调地狱,加一个请求就得从头开始捋...


axios.get(`${API_URL}/users/1`)
.then(response => {
console.log('1. 获取用户信息:', response.data.name);

// 获取该用户的帖子
axios.get(`${API_URL}/posts?userId=${response.data.id}`)
.then(postsResponse => {
console.log('2. 获取用户帖子:', postsResponse.data.length);

// 获取第一个帖子的评论
axios.get(`${API_URL}/posts/${postsResponse.data[0].id}/comments`)
.then(commentsResponse => {
console.log('3. 获取帖子评论:', commentsResponse.data.length);

// 获取第一条评论的作者信息
axios.get(`${API_URL}/users/${commentsResponse.data[0].id}`)
.then(userResponse => {
console.log('4. 获取评论作者:', userResponse.data.name);

// 获取该作者的相册
axios.get(`${API_URL}/albums?userId=${userResponse.data.id}`)
.then(albumsResponse => {
console.log('5. 获取作者相册:', albumsResponse.data.length);

// 结果
console.log('6. 最终结果:', {
originalUser: response.data.name,
postCount: postsResponse.data.length,
commentCount: commentsResponse.data.length,
commentAuthor: userResponse.data.name,
albumCount: albumsResponse.data.length
});
})
.catch(err => console.error('获取相册失败:', err));
})
.catch(err => console.error('获取评论作者失败:', err));
})
.catch(err => console.error('获取评论失败:', err));
})
.catch(err => console.error('获取帖子失败:', err));
})
.catch(err => console.error('获取用户失败:', err));

真是看的人想撞墙,不是吗?如果你不系统地学习js,而是像我一样作为一个业余爱好者,学来处理一些基础的业务,很容易写出这样的东西来。

实际上,现在不应当这么麻烦的。现在我们可以使用ES2017引入的async/await方式,来使异步代码看起来更像同步代码,从而提高可读性。通过使用async函数,我们可以在函数内部使用await关键字来等待Promise的解决,这样代码结构更清晰,更易于维护。

async function fetchUserData() {
try {
// 1. 获取用户信息
const userResponse = await axios.get(`${API_URL}/users/1`);
console.log('1. 获取用户信息:', userResponse.data.name);

// 2. 获取该用户的帖子
const postsResponse = await axios.get(`${API_URL}/posts?userId=${userResponse.data.id}`);
console.log('2. 获取用户帖子:', postsResponse.data.length);

// 3. 获取第一个帖子的评论
const commentsResponse = await axios.get(`${API_URL}/posts/${postsResponse.data[0].id}/comments`);
console.log('3. 获取帖子评论:', commentsResponse.data.length);

// 4. 获取第一条评论的作者信息
const commentAuthorResponse = await axios.get(`${API_URL}/users/${commentsResponse.data[0].id}`);
console.log('4. 获取评论作者:', commentAuthorResponse.data.name);

// 5. 获取该作者的相册
const albumsResponse = await axios.get(`${API_URL}/albums?userId=${commentAuthorResponse.data.id}`);
console.log('5. 获取作者相册:', albumsResponse.data.length);

// 6. 最终结果
const result = {
originalUser: userResponse.data.name,
postCount: postsResponse.data.length,
commentCount: commentsResponse.data.length,
commentAuthor: commentAuthorResponse.data.name,
albumCount: albumsResponse.data.length
};

console.log('6. 最终结果:', result);
return result;

} catch (error) {
console.error('请求过程中发生错误:', error.message);
throw error;
}
}

这样,回调地狱消失了,程序变得清晰整洁。

这时候就会有人问了,分开处理了所有的业务,这样性能会受到影响吗,一定程度确实会。我们的程序还有优化的空间:我们可以使用Promise.all,把两个变量放在一起并行请求,节省时间:


async function fetchOptimizedData() {
try {
// 1. 获取用户基本信息 (并行获取用户和用户帖子)
const [userResponse, postsResponse] = await Promise.all([
axios.get(`${API_URL}/users/1`),
axios.get(`${API_URL}/posts?userId=1`)
]);

console.log('1. 获取用户信息:', userResponse.data.name);
console.log('2. 获取用户帖子:', postsResponse.data.length);

// 2. 获取第一个帖子的评论和第一条评论的作者信息 (并行)
const [commentsResponse, commentAuthorResponse] = await Promise.all([
axios.get(`${API_URL}/posts/${postsResponse.data[0].id}/comments`),
axios.get(`${API_URL}/users/${userResponse.data.id}`) // 假设这里需要获取的是评论作者
]);

console.log('3. 获取帖子评论:', commentsResponse.data.length);
console.log('4. 获取评论作者:', commentAuthorResponse.data.name);

// 3. 获取该作者的相册和待办事项 (并行)
const [albumsResponse, todosResponse] = await Promise.all([
axios.get(`${API_URL}/albums?userId=${commentAuthorResponse.data.id}`),
axios.get(`${API_URL}/todos?userId=${commentAuthorResponse.data.id}`)
]);

console.log('5. 获取作者相册:', albumsResponse.data.length);
console.log('6. 获取作者待办事项:', todosResponse.data.length);

// 返回最终结果
return {
user: userResponse.data,
postCount: postsResponse.data.length,
commentCount: commentsResponse.data.length,
commentAuthor: commentAuthorResponse.data,
albumCount: albumsResponse.data.length,
todoCount: todosResponse.data.length
};

} catch (error) {
console.error('请求过程中发生错误:', error.message);
throw error;
}
}

这样,原本的时间为"请求1+请求2"的时间,现在并行请求就变成了每一次请求中,最慢的那个函数的时间。

有的人觉得这样等待,不会使得被堵塞吗?并不会。这个函数是在程序中统一async调用。await仅暂停​​当前 async 函数​​,并不会阻塞主线程,因为底层基于 Promise,本质仍是异步,不会冻结UI等等;

当然还有最后一个问题:每一次请求都只有获取了,从而报错统一处理。忘记了某一次就会导致未处理 rejection。这个时候建议使用全局的错误监听,这样遇到了也不会导致未处理的错误导致崩溃。

// 浏览器全局错误监听
window.addEventListener('unhandledrejection', (event) => {
// 阻止默认行为(控制台报错)
event.preventDefault();

console.error('[浏览器] 未处理的 Promise 拒绝:', event.reason);

// 可在此处添加其他逻辑(比如说上报?
reportErrorToServer(event.reason);
});

// 以及Node.js
process.on('unhandledRejection', (reason, promise) => {
console.error('[Node.js] 未处理的 Promise 拒绝:', reason);

// 可在此处添加其他逻辑(比如说上报?
reportErrorToServer(reason);

// 防止进程崩溃(看情况)
// process.exit(1); // 严重错误时就直接及时止损(爆!)
});

优雅的代码使人事半功倍,这就是我从中得到的最大的收获。

关于在Android容器内运行Linux启动Docusarus出现“Unknown system error 13”问题的解决方法

· 阅读需 2 分钟
兔兔
兔兔

前些日子喜欢使用米pad5pro运行linux容器进行一些轻开发。不过我在使用Linux容器进行Docusarus的博客编写的时候,发现直接使用npm start没有办法正常启动预览:

> my-website@0.0.0 start
> docusaurus start

[INFO] Starting the development server...
node:os:68
throw new ERR_SYSTEM_ERROR(ctx);
^

SystemError [ERR_SYSTEM_ERROR]: A system error occurred: uv_interface_addresses returned Unknown system error 13 (Unknown system error 13)
at Object.networkInterfaces (node:os:277:16)
at address.interface (/root/DanielToyama.github.io/node_modules/address/lib/address.js:71:23)
at address.ip (/root/DanielToyama.github.io/node_modules/address/lib/address.js:111:22)
at /root/DanielToyama.github.io/node_modules/detect-port/lib/detect-port.js:88:32
at Server.<anonymous> (/root/DanielToyama.github.io/node_modules/detect-port/lib/detect-port.js:118:12)
at Object.onceWrapper (node:events:632:28)
at Server.emit (node:events:518:28)
at emitListeningNT (node:net:1906:10)
at process.processTicksAndRejections (node:internal/process/task_queues:81:21) {
code: 'ERR_SYSTEM_ERROR',
info: {
errno: 13,
code: 'Unknown system error 13',
message: 'Unknown system error 13',
syscall: 'uv_interface_addresses'
},
errno: [Getter/Setter],
syscall: [Getter/Setter]
}

Node.js v20.11.1

究其原因,其实是因为容器proot环境的docusarus没有使用0.0.0.0的ip进行创建服务器的权限。解决办法也很简单,使用127.0.0.1进行启动就可以了:

使用启动指令npm run start -- --host 127.0.0.1 就可以正常启动端口开始愉快的玩耍了

当然你也可以把这个东西写进package.json的启动指令,以后就可以进行快速调用:

/package.json
  "scripts": {
"docusaurus": "docusaurus",
"start": "docusaurus start",
"local": "docusaurus start --host 127.0.0.1",
"build": "docusaurus build",
"swizzle": "docusaurus swizzle",
"deploy": "docusaurus deploy",
"clear": "docusaurus clear",
"serve": "docusaurus serve",
"write-translations": "docusaurus write-translations",
"write-heading-ids": "docusaurus write-heading-ids"
},

这样使用指令npm run local就可以从127.0.0.1启动了

创建了评论系统

· 阅读需 1 分钟
兔兔
兔兔

突发奇想给博客接入了评论区,点进文章页面最底下Github登录就可以发表评论

虽然没什么用(?)但是弄一个好有趣()

把密码直接保存在你的浏览器上有多危险?

· 阅读需 4 分钟
兔兔
兔兔

今天偶尔看到一个Github项目:HackBrowserData

这个工具是一个命令行工具,用于从浏览器解密和导出浏览器数据(密码、历史记录、cookie、书签、信用卡、下载历史记录、localStorage 和扩展)。它支持基本上市面上流行的浏览器,以及Windows、macOS 和 Linux 三端支持。

浏览器密码Cookie书签历史记录
Google Chrome
Google Chrome Beta
Chromium
Microsoft Edge
360 Speed
QQ
Brave
Opera
OperaGX
Vivaldi
Yandex
CocCoc
Firefox
Firefox Beta
Firefox Dev
Firefox ESR
Firefox Nightly
Internet Explorer

以上是它列出的Windows端的支持导出的功能。一般的讲,在浏览器里面查看自己的账号密码是要输入电脑的PIN或者密码,然而这个小工具完全不需要知道这些,只需要一个指令,你所有的隐私就会被全部导出到表格,一览无遗。

实际上想一想还是非常可怕的,如果有一个其他的软件附带了这个工具,一个调用就能获得你的几乎所有内容。浏览器作为互联网入口,里面几乎保存了所有平台我们的登录信息和密码,拿到这些东西基本上你的所有平台都能进行访问了。

即使是你开了二步验证,短时间内,导出来的cookie也能用于访问你所登录过的页面进行操作,想想就令人不栗而寒。

如果想把这个工具下载下来看一看,可以点击文章开头的链接。不过强烈不建议你在自己的电脑上运行这个工具,虽然工具是开源的,但是你没自己审核过,你不能确保里面真的完全没有泄漏你隐私的代码,更不能保证Github导出供下载的二进制文件里面的代码都是来自源代码编译的。

晚安

鸣潮安可皮肤

· 阅读需 1 分钟
兔兔
兔兔

鸣潮安可自制皮肤

哔哩哔哩BV1Eo6PYQESv,来给我三连呗~~~

下载地址 密码:5h1x

危险

如果你用蓝奏云下载东西的时候发现下载下来的文件是 .exe 结尾的可执行文件,千万不要打开,立即删除!

近日有up发现蓝奏云的点了下载之后的文件开始分发带有exe的程序,分发推广文件实则为p2p下载器,安装捆绑第三方程序,不要打开,不要打开!!!

出处:哔哩哔哩/【紧急扩散】MC玩家请警惕蓝奏云下载陷阱

鸣潮今汐皮肤

· 阅读需 2 分钟
兔兔
兔兔

闲的没事研究了一下搜狗输入法的皮肤自制工具,

制作了一些鸣潮的小皮肤,哔哩哔哩BV19szTY7EPT,来给我三连呗~~~

萌新第一次做()

下载地址:

普通版 密码:8p3b,标准版本

动态版 密码:2fm2,顺便用动态表情也做了一个版本,感觉效果一般般不过也传了

危险

如果你用蓝奏云下载东西的时候发现下载下来的文件是 .exe 结尾的可执行文件,千万不要打开,立即删除!

近日有up发现蓝奏云的点了下载之后的文件开始分发带有exe的程序,分发推广文件实则为p2p下载器,安装捆绑第三方程序,不要打开,不要打开!!!

出处:哔哩哔哩/【紧急扩散】MC玩家请警惕蓝奏云下载陷阱

2024年,如何使用shizuku来给SD分区且融卡

· 阅读需 5 分钟
兔兔
兔兔

最近有一位朋友试图使用外接TF卡来拯救自己的所剩无几的内存,但是又苦于没有电脑。那好吧!能不能使用shizuku呢?于是就有了这篇文章。

首先,就是安装并且激活shizuku。这一步我想大家都会,因此我也不在此过多论述

其次,给第三方终端激活shizuku:

如果要不使用adb使用shell命令,那必然离不开shizuku。但是并不是每一个shell都接入了shizuku,那么怎么办呢?

不知道从何时起,shizuku支持了rish————从shizuku导出一个shell文件来访问shizuku:

Rish is an Interactive SHell for android

那么事情就变简单了,使用终端访问rish文件即可获得shell权限:

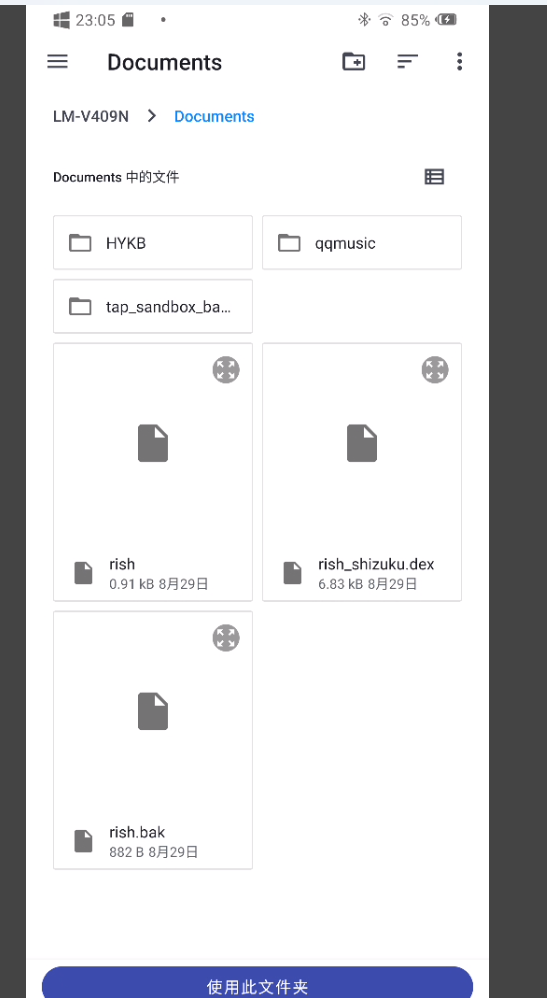
使用shizuku导出rish文件到你喜欢的目录,这里我选择直接导出到documents文件夹 alt text

随后,你需要获取到你喜欢的终端软件的包名在这里,我选择了终端模拟器(jackpal.androidterm),

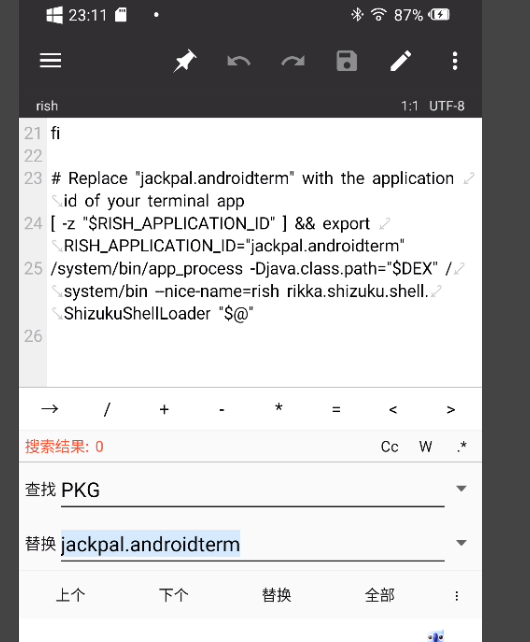
我们需要在rish中,单独给予这个终端软件访问shizuku的权限:使用mt管理器等软件,使用文本方法打开rish,右上角使用替换,把所有的PKG替换为终端包名,随后保存rish文件。从此一个此终端专用的shell就这样做好了

alt text

接下来使用终端打开shell文件:为了避免终端打开不了其他文件,先给予终端访问所有文件的权限,然后新建一个窗口,使用命令

cd /storage/emulated/0/Documents/

来使终端打开到这个放了rish的文件夹,当然你的路径可能和我不一样

使用

sh ./rish

来激活shizuku。出现授权便是激活成功了(只会在第一次提示)。不过此后每次你要用都得这样激活一次

接下来便是和adb的步骤大同小异了,只不过省略了电脑需要的adb shell前缀:

危险

接下来的操作会抹除你的TF卡上的所有数据,请你务必做好备份!!!

首先使用

sm list-disks

获取你所访问的sd卡的磁盘名,执行完之后,屏幕可能显示:

disk:179,32

获取到的就是你的磁盘名,你的可能和我不一样

使用命令开始分盘:

sm partition disk:179,32 mixed 40

这个地方的mixed 40代表留下40%的空间用来留给文件,60%存软件,你可以根据自己的喜好来决定这个内存,然后这个地方要写你的磁盘名,我的可能和你不一样

执行完会稍微有一小段停顿,意味着正在执行。出来下一行命令开始让你输入时候就意味着代码已经执行完毕了,可以前往设置看看有没有成功了

然后的话...如果你运气好,可能可以看见手机的设置出现了移动app到内存卡,那就可以直接移动了。运气不好的,可以尝试使用“打开快捷方式app”,然后显示系统应用,设置,存储(或者类似的词)看看能不能调用软件移动的接口。你可能还需要前往开发者模式,翻到最底下,然后打开强制允许将应用写入外部存储设备。大概就是这样。

再不行的话...也许你应该使用命令

sm partition disk:179,32 public

来让他回到一张正常的sd卡,还是放过他吧————不过不要忘记把磁盘名字改成你自己的磁盘名字!

注意

如果你此前往文件分区放置了内容,依旧会被抹除,请务必备份

从GPL协议的角度,讲讲我对近日lchzh3473事件的看法

· 阅读需 5 分钟
兔兔
兔兔

最近lchzh3473的风波算是卷袭了整个Phi圈。起因是up@沉默-_-微笑多个视频使用了@lchzh3473的模拟器的视频被lchzh以版权问题的原因而举报下架,其对此事的动态也被举报下架。

此事之后lchzh在phi圈引发了一部分人的不满。真正使其成为众所矢之的事情,是其于其在5.6时,举报了3个@沉默-_-微笑使用Phigros官方游戏的游玩视频并且成功,至此之后,在phi圈引发了较大的风波。

此事孰是孰非一目了然,我也不愿在此事件上纠结过多;但是值得注意的是,lchzh3473的sim-phi使用了GPLv3的licence。作为使用了自由软件的许可证的程序,lch制定各种手元视频附带要求的合理性我觉得十分有必要讨论。

既然sim-phi使用了GPLv3的licence,这也就意味着simphi是作为自由软件发布的,本协议明确确认你不受限制地运行未修改的程序的权利。仅在输出内容构成受保护的作品时,运行受保护的作品所产生的输出受本协议的约束。GPL的核心精神便是使用自由软件。根据GPLv3的第二项:基本权利的原文:“This License explicitly affirms your unlimited permission to run the unmodified Program. The output from running a covered work is covered by this License only if the output, given its content, constitutes a covered work. ”(本协议明确确认你不受限制地运行未修改的程序的权利。仅在输出内容构成受保护的作品时,运行受保护的作品所产生的输出受本协议的约束。),

由上,我认为lzhch3473要求游玩者发布视频时必须标注作者名字是完全不符合GPL的规定的,哪怕是作者本人发布的也不符合,因为simphi是以gpl发行的。很明显,模拟器游玩的录制视频是属于程序输出内容的,而输出内容(铺面的内容和借此录制的视频手元)并不包括模拟器的源代码以及模拟器程序的本身(视频并不是模拟器本体吧)。不知道@lzhch3473怎么看?

作为开源软件的开发者,我认为lchzh3473的行为不仅仅是伤害到了phi自制圈,也是对整个开源圈子的一种伤害。由此我坚决抵制lchzh3474使用着gpl协议但是又违反着它的行为。

Tip:根据GPLV3第二条基本许可,“根据本协议授予的所有权利的期限为程序的版权期限,此等授权在满足条件的情况下是不可撤销的。”由此更改许可证的方法也是无效的。

如果认为我上述辩论有缪误,欢迎来与我和平讨论,我将对此做出修改。


2024.12.20二编:

很惊讶我随手写的文章成为了我网站被bing搜索最多次的文章,并且输入“lchzh3473怎么了”,“lchzh3473事件”这些词都被bing列在了结果的前列

照着这种趋势,我估计我要被lchzh3473拉黑一辈子了XD